

Iedomājieties datu centra zāli, kur plaukti šalc kā orķestris, kas iesildās. Solists, kuru visi sagaida vadīt? Nvidia. Taču kompozīcija mainās, un jauna melodija no AMD var izcelties.
Kā Venice iegūst priekšrocību
Morgan Stanley jaunākais skatījums uz silīcija ainavu atainojas niansētā ainu. Nvidia 2027. gadā paliks TSMC lielākais CoWoS klients, bet AMD nākamās paaudzes EPYC sērija ar koda nosaukumu Venice tiek prognozēta pārdot vairāk procesoru vienību nekā Nvidia Vera.
Šeit skaitļiem ir nozīme. Banka prognozē, ka Nvidia Vera piegādes 2027. gadā būs aptuveni 5,75 miljoni vienību. Liels. Ambiciozs. Iespaidīgi priekš jauna servera procesora. Tomēr AMD Venice paredzēts sasniegt aptuveni 6,75 miljonus vienību, aptuveni par 17 procentiem vairāk nekā Vera un gandrīz 5,4 reizes vairāk nekā AMD lēstā 2026. gada 1,25 miljonu vienību apjoma.
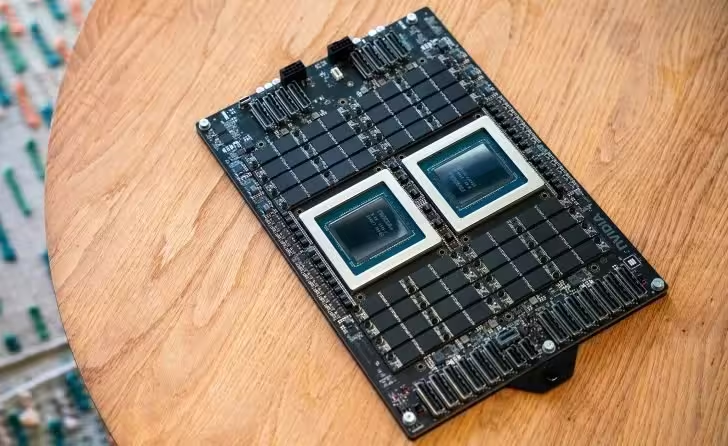
Vairāki tehniski un tirgus faktori veido šo atšķirību. Venice izstrādāta uz Zen 6 arhitektūras un izmantos TSMC 2 nanometru ražošanas procesu. Savukārt Vera fokusējas uz aģentu orientētām mākslīgā intelekta slodzēm un izmanto 3 nanometru procesu. Venice mērķis ir apvienot gan mākslīgā intelekta inferenci, gan augstas veiktspējas aprēķinu uzdevumus, paplašinot savus potenciālos lietošanas gadījumus.
Iepakojums un ražošanas jauda arī ir daļa no stāsta. TSMC waferu jauda tiek prognozēta sasniegt 200000 waferu mēnesī 2027. gadā, un Nvidia joprojām virzīs lielāko daļu CoWoS iepakojuma pieprasījuma. Morgan Stanley lēš, ka CoWoS-L izmantošana Nvidia mākslīgā intelekta GPU varētu pieaugt līdz aptuveni 910000 vienībām, kas ir aptuveni 40 procentu pieaugums gada griezumā. Vera piegādes arī tiek prognozētas dubultoties, un šādas kopīgas tendences palīdz izskaidrot, kāpēc Nvidia datu centru ieņēmumi varētu pieaugt vairāk nekā par 50 procentiem gada griezumā.
Tomēr izejvielu pieprasījuma skaitļi nav viss. Venice dizains, optimizēts gan mākslīgā intelekta inferencē, gan augstas veiktspējas aprēķinos, apvienojumā ar blīvāku procesa mezglu, dod AMD plašāku uzdevumu klāstu, ko iekarot. Šī daudzpusība var pārvērsties par lielāku vienību apjomu, it īpaši mākoņpakalpojumu sniedzēju vidū, kuri balansē jauktas slodzes.

Tad ir nezināmais faktors: pielāgota silīcija izstrāde. Lieli mākslīgā intelekta spēlētāji iegulda masīvi savos īpašajos mikroshēmojumos. OpenAI, Google, Amazon un citi vai nu sarunājas, vai virzās uz iekšējiem akceleratoriem. Kad hiperskalētāji izstrādā un ražo savu silīciju, viņi maina pieprasījuma dinamiku piegādātāju virzienā. Pielāgota silīcija parādīšanās sašaurina piegādes atšķirību, pievieno neparedzamību un liek tradicionālajiem piegādātājiem, piemēram, Nvidia un AMD, konkurēt ne tikai savā starpā, bet arī ar saviem klientiem.
Ko industrijas vērotājiem vajadzētu uzmanīgi vērot? Pirmkārt, mākoņpakalpojumu sniedzēju pieņemšanas modeļi: kurš izvēlas Venice un kurš Vera, un kur tiek izvietotas pielāgotas mikroshēmas? Otrkārt, ražojumu iznākums un rampas termiņi TSMC gan 2 nm, gan 3 nm mezgliem, jo procesa nobriešana var mainīt priekšrocības ātrāk nekā dizaina uzlabojumi. Treškārt, CoWoS iepakojuma jauda un prioritāšu sadale: pat ja pieprasījums pastāv, iepakojuma caurlaide un grafiki ir svarīgi.
Vispārīgi runājot, nākamie daži gadi būs mazāk par vienu uzvarētāju un vairāk par stratēģisku pozicionēšanos. AMD Venice izskatās gatava iegūt vienību apjoma līderību, pateicoties arhitektūras izvēlēm un procesa priekšrocībām, bet Nvidia dominēšana mākslīgā intelekta GPU iepakojumā un tās stiprās attiecības datu centru segmentā tur to cieši spēlē. Tajā pašā laikā pielāgota silīcija parādīšanās pievieno jaunu pretinieku laukā, kas var pārkārtot tirgus daļu kartes negaidītā veidā.
Sagaidiet svārstības. Sagaidiet pārsteigumus. Un sagaidiet, ka serveru plaukti turpinās šalc, jo skaitļošanas pieprasījums nerāda pazīmes palēnināšanai.

"Viedtālruņi un gadžeti. Es palīdzu lasītājiem izvēlēties labāko tehniku viņu vajadzībām."
Diskusija
Atstāt komentāru
Komentāri
Vēl nav komentāru. Esiet pirmais.