
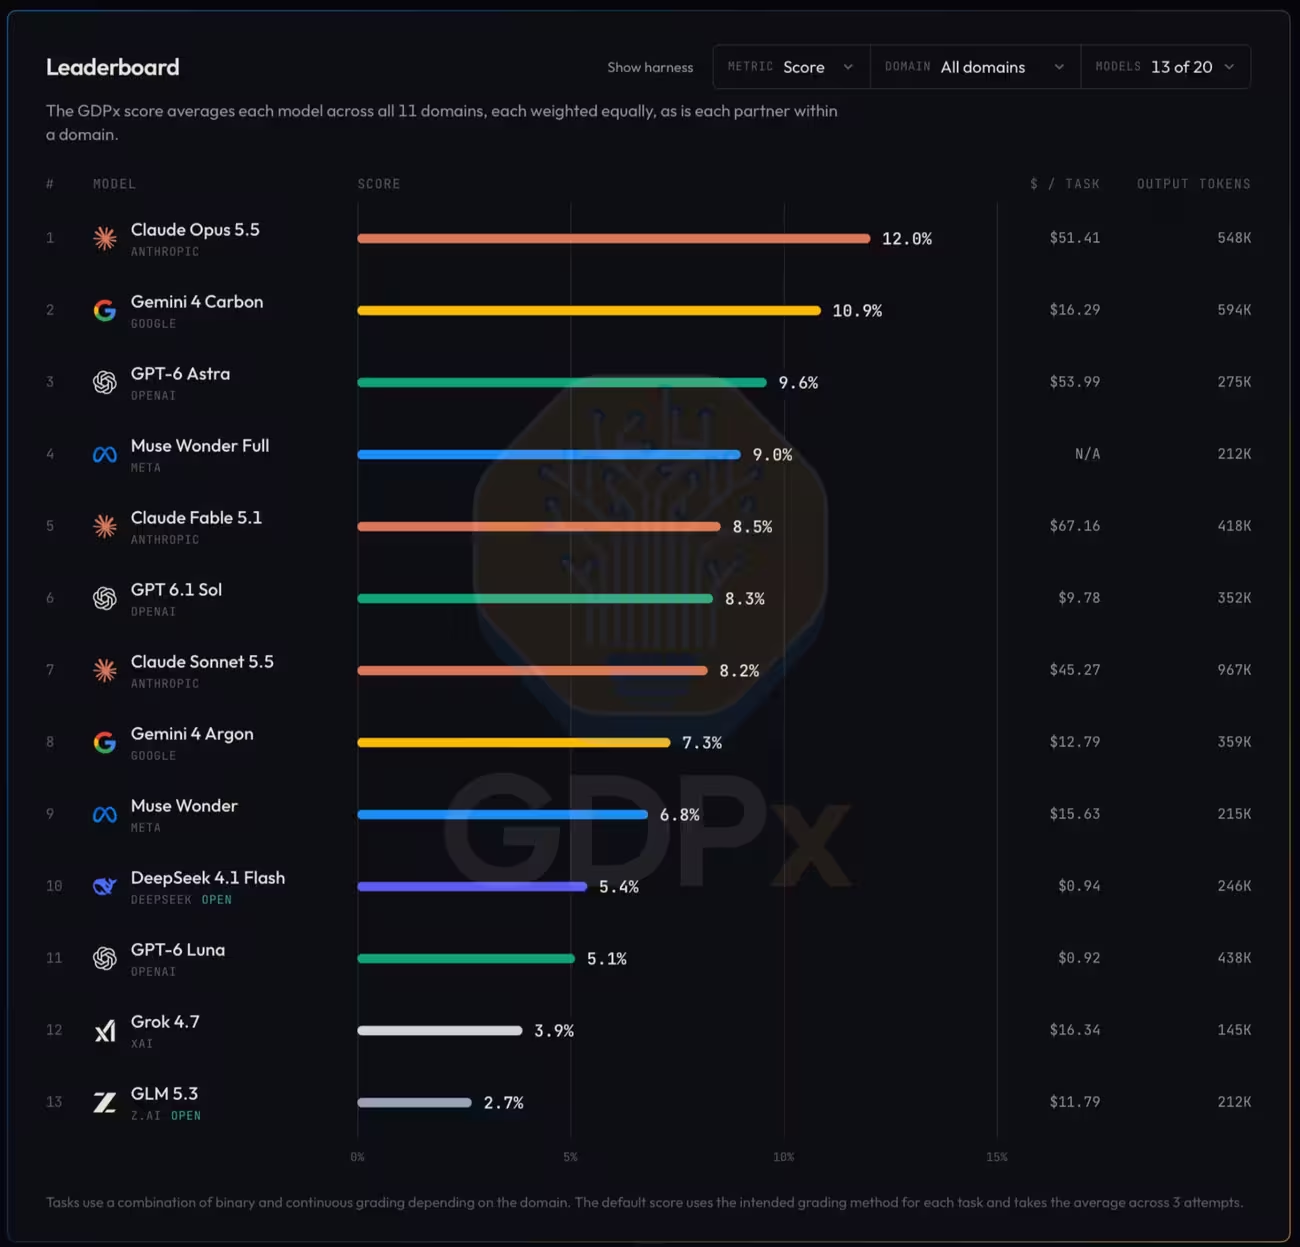
Google Gemini 4 Carbon samazina viena uzdevuma izpildes izmaksas līdz nedaudz vairāk nekā 16 USD — tas ir mazāk nekā trešdaļa no Anthropic Claude Opus 5.5 izmaksām, kas pēc SemiAnalysis GDPx etalona ir aptuveni 51 USD par uzdevumu.
GDPx reitingā Opus 5.5 ieņem pirmo vietu, bet Gemini 4 Carbon tam seko ar nelielu punktu starpību. Lai gan Gemini 4 Carbon nav līderis, tas apvieno tirgus līmenim līdzīgu veiktspēju ar ievērojami zemākām viena uzdevuma izmaksām, nodrošinot jaunajam Google modelim izteikti labu cenas un veiktspējas attiecību.
GDPx salīdzina Google, OpenAI, Anthropic un Meta vadošos modeļus, vērtējot gan to rezultātus, gan viena uzdevuma izpildes izmaksas. Etalons ietver 206 uzdevumus finanšu, materiālzinātnes, kiberdrošības, programmatūras inženierijas, tiesību un bioloģijas jomās, tādēļ rezultāti neaprobežojas ar vispārēju teksta ģenerēšanu vai atbildēm uz bieži uzdotiem jautājumiem.
Pilnajā GDPx reitingā Opus 5.5 sasniedz augstāko kopējo rezultātu, bet Gemini 4 Carbon tam seko ar salīdzinoši nelielu punktu starpību. Izmaksu atšķirība ir daudz izteiktāka: SemiAnalysis lēš, ka Opus 5.5 viena uzdevuma izpilde izmaksā aptuveni 51 USD, salīdzinot ar nedaudz vairāk nekā 16 USD Gemini 4 Carbon gadījumā. Nākamais tabulā ir OpenAI GPT-6 Astra, tomēr ziņojumā norādīts, ka tā rezultāts ir zemāks nekā Gemini 4 Carbon, savukārt vidējās izmaksas ir augstākas — aptuveni 54 USD par uzdevumu.
Trīs modeļu salīdzinājumā skaidri iezīmējas atšķirība starp veiktspējas un ekonomiskās vērtības līderi: Opus 5.5 ir pirmais pēc punktiem, Gemini 4 Carbon nodrošina līdzīgu veiktspēju par ievērojami zemāku cenu, bet GPT-6 Astra atpaliek no abiem un par katru uzdevumu izmaksā vairāk.
Koriģētais rangs un drošības filtri
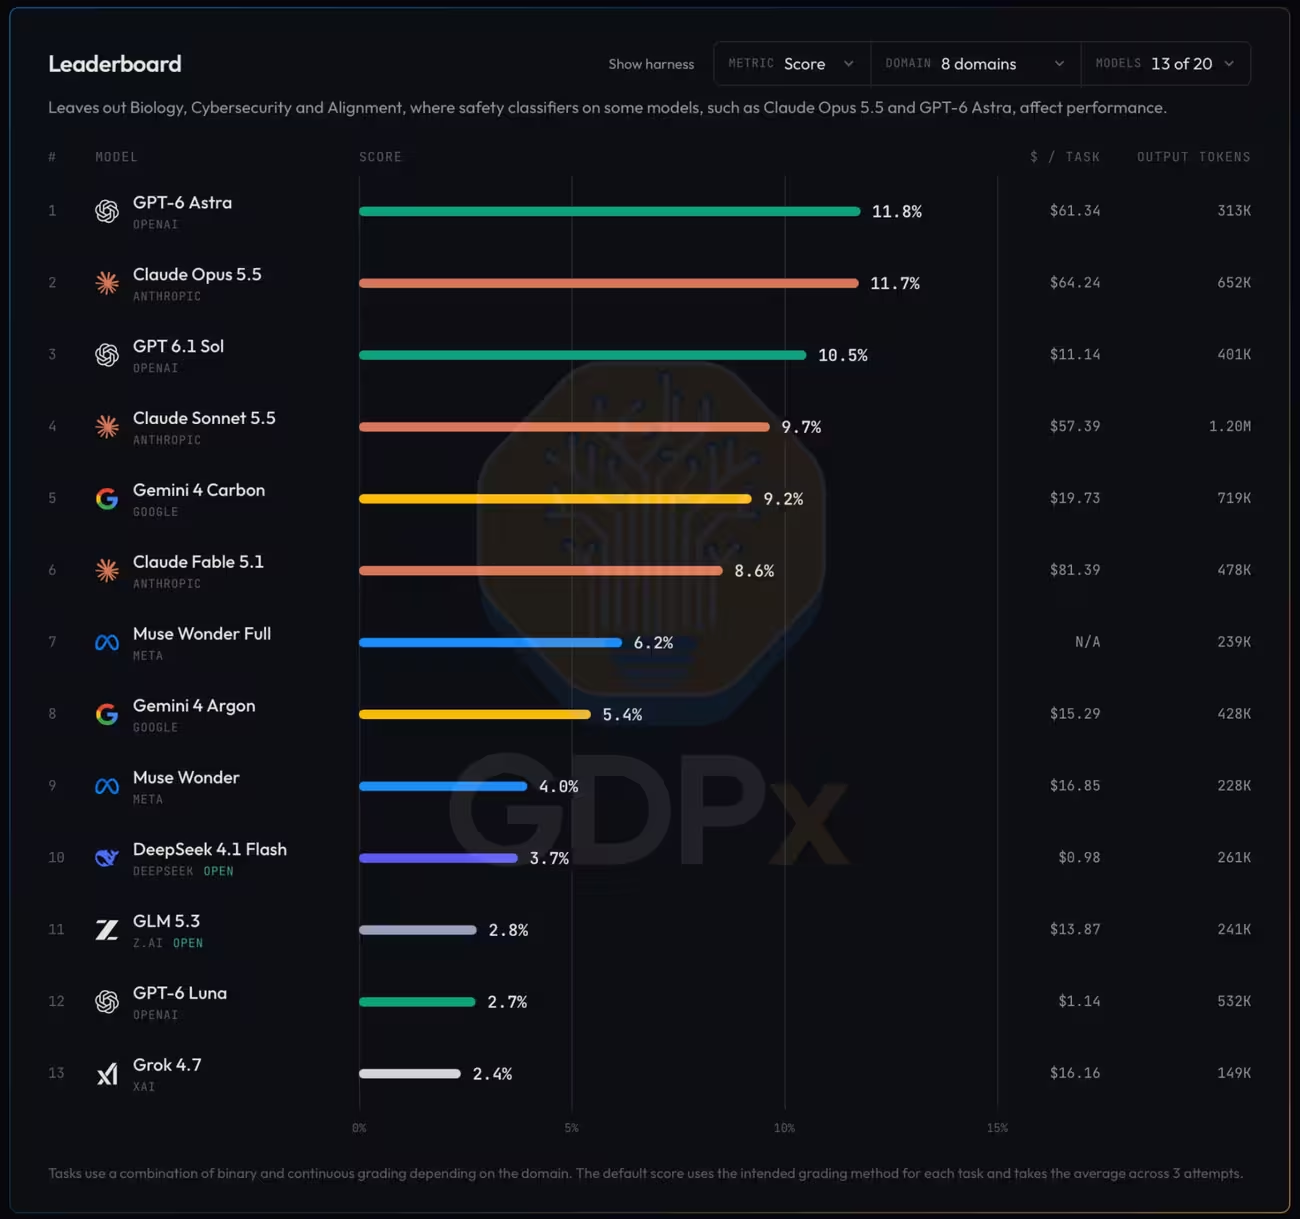
SemiAnalysis publicēja arī koriģētu reitingu, no kura izslēgti kiberdrošības, bioloģijas un saskaņošanas uzdevumi. Šo trīs jomu izņemšana mainīja vietu sadalījumu reitinga augšgalā: pirmajā vietā ierindojās GPT-6 Astra, bet GPT 6.1 Sol un Opus 5.5 koriģētajā sarakstā arī apsteidza Gemini 4 Carbon. Pētnieki norādīja, ka šis otrais vērtējums vairāk atbilst viņu subjektīvajam iespaidam par modeļu spējām.
Ziņojumā teikts, ka drošības ierobežojumi tādos modeļos kā Claude un dažās GPT versijās var neļaut izpildīt konkrētus kiberdrošības, bioloģijas vai saskaņošanas uzdevumus. Šie aizsardzības mehānismi var ietekmēt kopējos GDPx rezultātus, tāpēc modeļa vērtējums reizēm atspoguļo ne tikai tā tehniskās spējas, bet arī to, cik plaši tam ir atļauts atbildēt uz sensitīviem pieprasījumiem.
Google iepriekšējais vadošais modelis Gemini 4 Argon gan pilnajā, gan koriģētajā reitingā ieņēma astoto vietu — virs Meta Muse Wonder un zem Wonder Full. Argon viena uzdevuma izmaksas GDPx vērtējumā bija tikai nedaudz zemākas nekā Gemini 4 Carbon. Šī nelielā cenu starpība kopā ar Carbon augstāko vietu liecina par uzlabotu rezultāta un izmaksu līdzsvaru jaunākajā Google modelī.
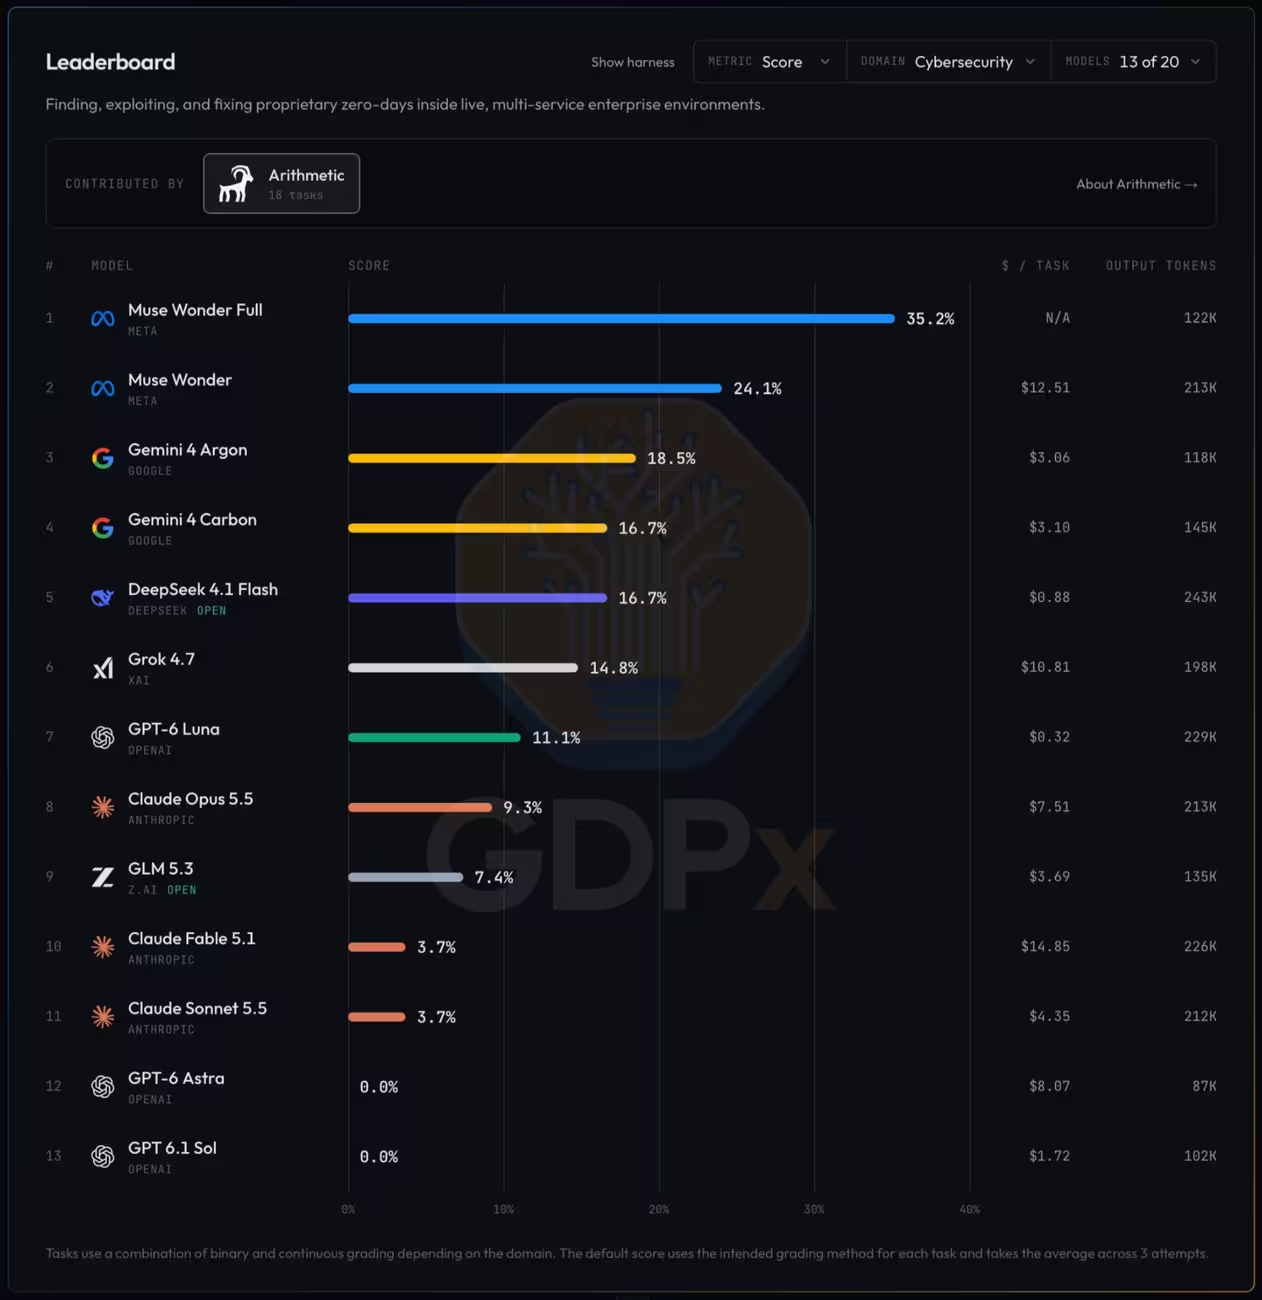
Vērtējot tikai kiberdrošības uzdevumus, aina mainās: abi Google modeļi šajā jomā pārspēja OpenAI un Anthropic, tomēr atpalika no Meta Muse modeļu saimes, ko GDPx raksturo kā ievērojami spēcīgāko kiberdrošībā. SemiAnalysis piebilst, ka norādītās izmaksu atšķirības var būtiski ietekmēt finanšu rādītājus liela apjoma, atkārtotas testēšanas un uzņēmumu ieviešanas scenārijos.

"Viedtālruņi un gadžeti. Es palīdzu lasītājiem izvēlēties labāko tehniku viņu vajadzībām."
Diskusija
Atstāt komentāru
Komentāri
Vēl nav komentāru. Esiet pirmais.