

Tiiny AI uzskata, ka nākamais solis mākslīgā intelekta aparatūrā vairs nebūs datu centra plauktā — tas iederēsies jūsu plaukstā. Startups ir atklājis Pocket Lab, plaukstas izmēra “superdatoru”, kas paredzēts, lai pilnībā lokāli (bez mākoņa) izpildītu 120 miljardu parametru lielus valodas modeļus (LLM).
Mazs ierīce, lieli apgalvojumi
Neļaujiet izmēram jūs maldināt. Aptuveni 14.2 × 8 × 2.53 cm un apmēram 300 gramu smagais Pocket Lab ir veidots patiesi pārnēsājamam. Taču Tiiny AI apgalvo, ka ierīce spēj hostēt smagas atvērtā koda modeļu versijas, kas parasti prasa dārgus GPU klasterus, nodrošinot doktora līmeņa loģisko secināšanu, sarežģītu daļēju analīzi un dziļu kontekstuālu izpratni bez mākoņa pakalpojumu izmantošanas.
Šāds kabatas superdators sola mainīt pieeju attīstītājiem, pētniekiem un uzņēmumiem, kas strādā ar lieliem valodas modeļiem (LLM), jo tā uzsvars uz lokālu apstrādi nozīmē zemu latentumu, mazākus atkārtotus izmaksu posteņus un pilnīgu datu kontrolei — aspekti, kas kļūst arvien svarīgāki datu suverenitātes un privātuma regulējumu kontekstā.
Specifikācijas, kas pamato interesi
Papīrā Pocket Lab izskatās kā koncentrēts servers. Galvenie punkti ietver:
- ARMv9.2 12 kodolu CPU vispārējām skaitļošanas vajadzībām
- Īpašs heterogēnais aprēķinu modulis (SoC + atsevišķs NPU), kas nodrošina aptuveni 190 TOPS
- 80 GB LPDDR5X atmiņa un 1 TB SSD, lai nodrošinātu lielu modeļu rezidentūru un ātru I/O
- Spēja pilnībā ierīcē darbināt līdz 120B parametru LLM, izmantojot agresīvu kvantizāciju
- Enerģijas profils mērķēts ap ~30W TDP un ~65W tipiskai sistēmas jaudai — ievērojami zemāks nekā salīdzināmiem serveru risinājumiem
- Offline-first darbība ar vienas pogas izvietojumu daudziem atvērtā koda LLM un aģentu ietvariem

Šie parametri liek saprast, kāpēc ierīce piesaista uzmanību gan kā tehniska demonstrācija, gan kā potenciāls produkts reālām lietošanas situācijām. LPDDR5X nodrošina zemu latentumu un augstu joslas platumu atmiņas piekļuvei, bet 1 TB SSD darbojas kā papildu modelēšanas rezerves vieta un ātrs apmaiņas slānis, kas ir būtiski, ja modeļi tiek kvantizēti un daļa parametru tiek izkrauta laika gaitā.
Kā ierīcei izdodas darbināt 120B modeļus kabatā?
Noslēpums ir aparatūras blīvums un programmatūras risinājumi. Pocket Lab iekļauj atsevišķu NPU, kas spēj sasniegt augstu TOPS līmeni, taču Tiiny AI balstās uz divām galvenajām tehnikām, lai padarītu lielos modeļus praktiskus ierobežotā silīcija vidē:
- TurboSparse — neironu līmeņa sparsās aktivācijas pieeja, kas samazina inferenču aprēķinu apjomu bez redzamas modeļa spriestspējas pasliktināšanās. Praktiski tas nozīmē, ka daudzām neironu reakcijām tiek novērsta nepieciešamība pilnībā aprēķināt, saglabājot sarežģītu spriestspēju ar krietni mazāku pavelkumu.
- PowerInfer — atvērtā koda heterogēnais inferenču dzinējs (bieži atrodams GitHub), kas dinamiskā veidā sadala slodzes starp CPU un NPU. Tas orkestrē aprēķinus tā, lai imitētu servera klases caurlaidspēju par daļu no parastā enerģijas patēriņa, izmantojot operatoru sapludināšanu, pielāgotas matricas karneles un laika plānošanu.
Savienojumā ar 80 GB LPDDR5X, kas ļauj izpildīt agresīvas kvantizācijas shēmas (piemēram, 4-bit vai pat 3-bit kvantizāciju ar prasmīgu skalēšanu un grupu kvantizāciju), un atmiņas efektīvām izpildes metodēm (piemēram, aktivācijas rematerializācija un atmiņas ofload), šīs tehnoloģijas padara 120B modeļu lokālu darbību ticamu, nevis tikai teorētisku iespēju.
Turklāt programmatūras optimizācijas, piemēram, operatoru fūzija, cache-aware izpilde un specializēti matricas saspiešanas algoritmi, ļauj NPU efektīvāk izmantot 190 TOPS ražību. Tas nozīmē, ka liela daļa intensīvo lineāro algebra operāciju tiek pārvietota uz NPU, kamēr kontrolējošās un nelineārās daļas paliek CPU pārziņā, nodrošinot līdzsvarotu un zemu enerģijas patēriņu radošu uzdevumu izpildei.
Modeļi, privātums un reālas pasaules pielietojumi
Pocket Lab atbalsta plašu atvērtu modeļu katalogu — sākot ar GPT-OSS un Llama līdz Qwen, Mistral un Phi — ļaujot izstrādātājiem izvēlēties arhitektūru, kas vislabāk atbilst viņu vajadzībām. Tā kā ierīce darbojas pilnībā offline, tā ir pievilcīga privātuma orientētiem izvietojumiem, terēna pētījumiem un izstrādātājiem, kuri vēlas ātras iterācijas bez mākoņa latentuma vai atkārtotām izmaksām.
Uzņēmuma mērķa lietošanas scenāriji aptver vairākas nozares:
- Terēna pētniecība: zinātnieki lauka apstākļos var izmantot pilnvērtīgus LLM bez datu sinhronizācijas ar mākoņiem.
- Veselības aprūpe un konfidenciāli dati: pacientu informācija var palikt lokāli, samazinot atbilstības riskus un datu noplūdes iespējas.
- Drošās vides un rūpniecība: aizsardzības nozare un drošības svarīgas infrastruktūras var darbināt modeļus izolētā režīmā.
- Mobils izstrādes darbs un aģentu testēšana: izstrādātāji var ātri izveidot un pārbaudīt aģentu darbplūsmas uz saviem galdiem bez serveriem.
Praktiski runājot, tas nozīmē, ka izstrādātājs var izveidot, apmācīt vai pielāgot aģentu darbību uz galda un nekad nesūtīt sensitīvu kontekstu uz mākoņiem. Tas būtiski paātrina iterācijas ciklu, mazina izmaksas un padara iespējamu jaunu veidu lietojumprogrammas ar uzlabotu privātumu — piemēram, personisko asistentu risinājumus, kas nekad neizpauž lietotāja datus ārpus ierīces.
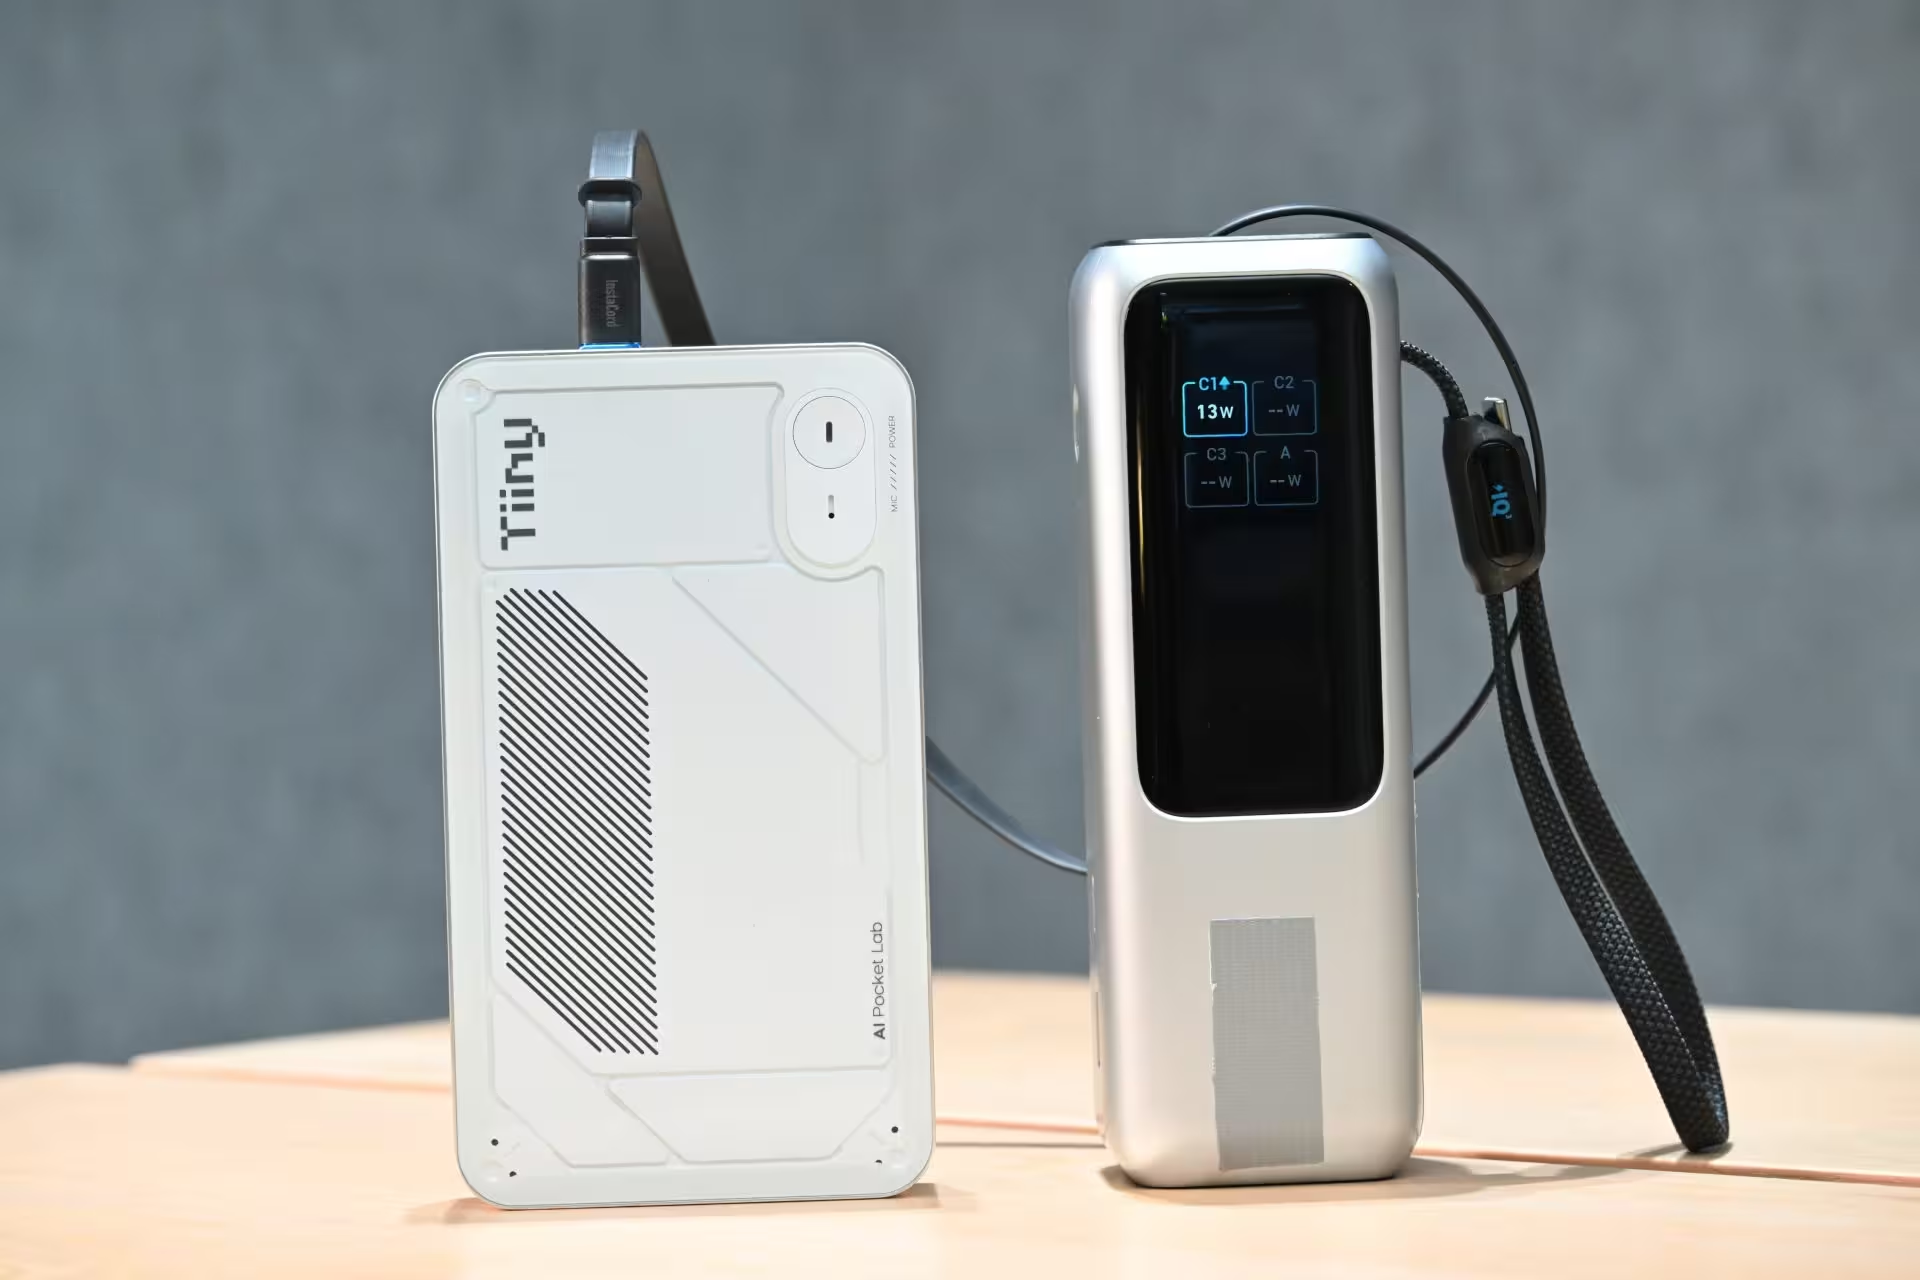
Attēlā redzama ierīce, kas darbināta ar ārēju barošanas banku — tas uzsver mobilitāti un to, ka mikrosistēmas enerģijas vadība ir optimizēta reāla lietojuma scenārijiem. Savienojamība ar ārējiem enerģijas avotiem padara šo risinājumu piemērotu pārvietojamiem darbiem, terēna testiem vai situācijām, kur piekļuve tīklam vai stacionārai jaudai nav iespējama.
Nākamie soļi: CES un neatbildētie jautājumi
Tiiny AI plāno demonstrēt Pocket Lab CES 2026 izstādē, kur tehniskie demonstrējumi un reālie testa rezultāti būs būtiski, lai novērtētu ierīces praktiskumu. Uzņēmums vēl nav paziņojis cenu vai piegādes datumus, un dzīvē veiktie rūpnieciskie etaloni būs izšķirošs tests: vai kabatas izmēra mašīna konsekventi spēs atbilst serveru klases slodzēm dažādos scenārijos?
Jautājumi, uz kuriem gaidāmi atbildes nākotnē, ietver:
- Reālie etaloni: kā Pocket Lab salīdzinās ar nelieliem serveru risinājumiem NLP caurlaidspējas, latentuma un enerģijas efektivitātes ziņā?
- Ilgtermiņa uzticamība: kā ierīce tiks galā ar termālo menedžmentu ilgstošas intensīvas slodzes apstākļos?
- Drošība un atjauninājumi: kā tiks risināta programmatūras atjaunināšana, drošības plāksteri un modeļu versiju pārvaldība bez tiešsaistes savienojuma?
- Ekosistēmas atbalsts: cik viegli izstrādātāji varēs portēt populāros rīkus un aģentu ietvarus uz Pocket Lab platformas?
Pat ja daudzas atbildes vēl nav pieejamas, Pocket Lab signalizē par aizraujošu virzienu. Edge AI pārvietojas ārpus maziem sensoriem un iebūvētām ierīcēm uz patiesi jaudīgām, privātām skaitļošanas platformām — un tas var mainīt veidu, kā izstrādātāji, pētnieki un privātumu cienoši lietotāji mijiedarbojas ar LLM.
Strauji attīstoties aparatūras akceleratoriem (piemēram, specializētiem NPU), atmiņu tehnoloģijām (LPDDR5X) un programmatūras optimizācijām (dinamiska kvantizācija, sparsity-aware kompilatori), šādas ierīces var kļūt par parastu izvēli risinājumiem, kur nepieciešama lokāla, zemu latentuma un droša teksta apstrāde. Tomēr ilgtermiņa panākumi būs atkarīgi no reāliem rezultātiem laboratorijā un lauka testos, izstrādātāju atbalsta un pieejamības izmaksu struktūras.
Kopumā Pocket Lab ir interesants solis pretim tam, lai padarītu lielos valodu modeļus praktiski pieejamus ārpus datu centra — īpaši tur, kur privātums, ātrums un enerģijas efektivitāte ir būtiski kritēriji.

"IT speciālists un žurnālists. Es rakstu par kiberdrošību, blokķēdēm un digitālo transformāciju."
Diskusija
Atstāt komentāru
Komentāri (2)
Piedod, bet izklausās pārāk labi lai būtu taisnība. Forša ideja, bet baterija, updates un drošība, lielas lietas. Ja CES parādīs reālu darbību, varētu nopietni interesēties.
Nu, ja tas tiešām 120B lokāli un 30W, tad wow. Bet reāli etaloni? siltums, throttling, cena, kur fakti? skeptisks, bet ceru.